
Exécutez un Modèle IA 27B Gratuitement
avec 32 Go de VRAM 🤯
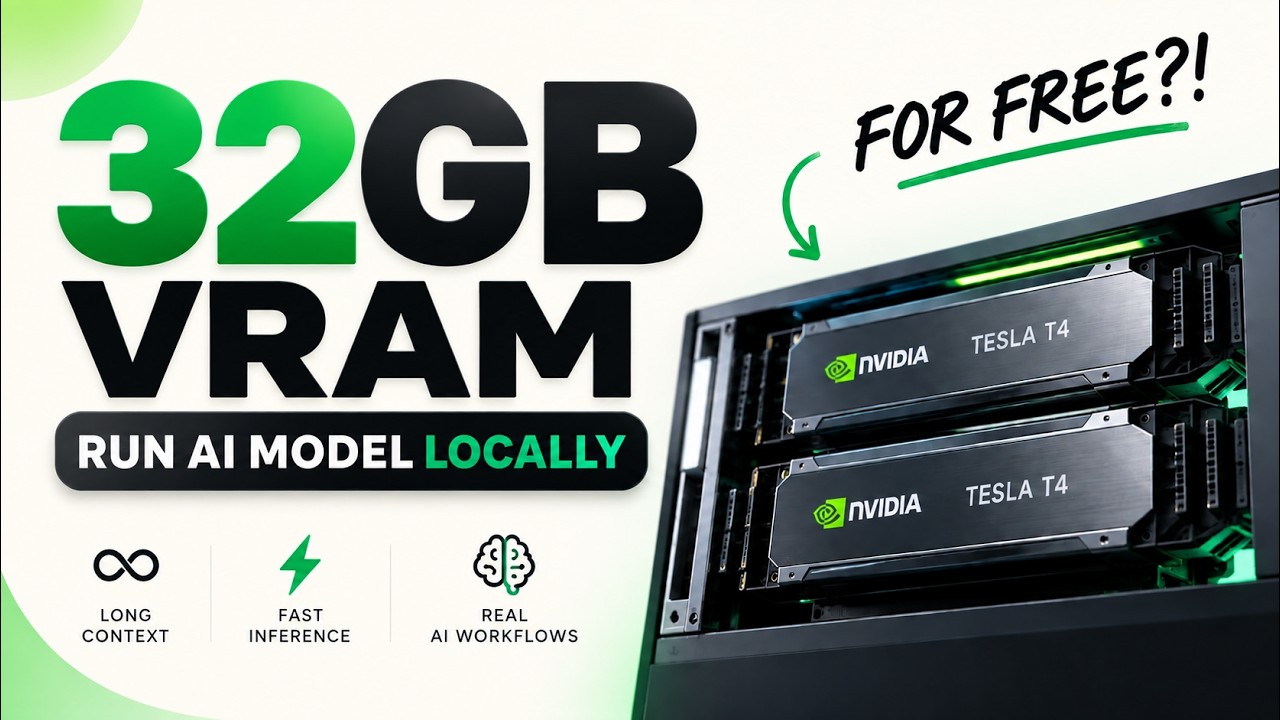
Découvrez comment transformer un environnement Kaggle gratuit en un puissant serveur d’inférence IA à l’aide de 2 GPU Tesla T4 et d’Ollama. Aucune carte de crédit requise !
🎯 Ce que vous allez apprendre dans ce tutoriel
Ce guide complet vous emmènera d’un environnement Kaggle vierge à un serveur d’IA entièrement fonctionnel capable d’exécuter des modèles de langage de 27 milliards de paramètres. Voici ce que nous allons couvrir :
- Comment obtenir un accès gratuit à 2 GPU Tesla T4 (32 Go de VRAM combinés) sur Kaggle
- Comment configurer Ollama pour l’inférence multi-GPU et optimiser la répartition de charge
- Comment exécuter un modèle 27B quantifié Q4 avec une fenêtre de contexte massive de 64K tokens
- Comment créer et utiliser un modèle MTP (Multi-Token Prediction) pour accélérer la génération
- Comment maintenir le modèle chargé en VRAM pour des inférences rapides et éviter les rechargements
- Comment surveiller l’utilisation GPU en temps réel avec nvidia-smi et optimiser les performances
- Comment benchmarker la vitesse de génération et mesurer les tokens/seconde
- Comment exposer votre serveur Ollama via une API publique temporaire sécurisée avec Cloudflare Tunnel
- Comment intégrer le serveur avec Hermes Agent et OpenCode pour de vrais workflows de codage IA
- Comment utiliser votre serveur GPU distant pour des tâches réelles de développement assisté par IA
🛠️ Le Guide Complet Étape par Étape

1. Configuration de Kaggle et Importation du Notebook (01:36)
Prérequis : Un compte Kaggle gratuit (inscription en 2 minutes). Kaggle offre environ 30 heures de GPU par semaine, ce qui est largement suffisant pour tester et expérimenter.
Étapes détaillées :
- Créez un nouveau notebook Kaggle ou importez le notebook fourni dans la description
- Activez l’accélérateur GPU dans les paramètres du notebook (Settings > Accelerator > GPU T4 x2)
- Vérifiez que les deux GPU Tesla T4 sont détectés avec la commande
nvidia-smi - Le notebook configure automatiquement l’environnement Linux, installe les dépendances (Python, CUDA, etc.)
- Configuration du réseau et préparation de l’environnement pour Ollama
# Vérification des GPU disponibles
!nvidia-smi

# Devrait afficher 2x Tesla T4 avec 15109 MiB de VRAM chacun
Astuce pro : Les sessions Kaggle durent jusqu’à 12 heures maximum. Pensez à sauvegarder régulièrement votre travail et à exporter vos modèles si nécessaire.

2. Installation d’Ollama et Exécution du Modèle 27B (04:46)
Ollama est l’outil qui va simplifier le déploiement et la gestion de notre modèle de langage. Il gère automatiquement le téléchargement, la quantification et l’optimisation pour GPU.
Processus d’installation :
- Installation d’Ollama via le script officiel en une seule commande
- Téléchargement du modèle Qwen3.8 27B Uncensored Q4_K_M (environ 17 Go)
- Configuration de la fenêtre de contexte à 64K tokens pour des conversations longues
- Activation du support multi-GPU pour répartir la charge sur les 2 Tesla T4
# Installation d'Ollama
curl -fsSL https://ollama.com/install.sh | sh

# Lancement du modèle avec contexte étendu
ollama run qwen3.8:27b-q4_K_M --num_ctx 64000
Pourquoi Q4_K_M ? Cette quantification en 4-bit offre un excellent compromis entre qualité et performance. Le modèle occupe ~17 Go au lieu de ~52 Go en FP16, tout en conservant une qualité de génération quasi-identique.

3. MTP, Charge GPU et Benchmark de Performance (09:23)
Cette étape cruciale permet d’optimiser les performances et de vérifier que tout fonctionne correctement.
Multi-Token Prediction (MTP)
Le MTP est une technique avancée qui permet au modèle de prédire plusieurs tokens simultanément, accélérant ainsi considérablement la génération. Le modèle Qwen3.8 inclut un head MTP spécialisé.
Surveillance GPU avec nvidia-smi
Utilisez cette commande pour vérifier en temps réel :
- L’utilisation de la VRAM sur chaque GPU
- L’utilisation des cœurs CUDA
- La température et la consommation énergétique
- La répartition de charge entre les 2 GPU
# Surveillance en temps réel (rafraîchissement 1s)
watch -n 1 nvidia-smi

# Vous devriez voir les 2 GPU actifs avec ~8-9 Go de VRAM utilisés chacun
Benchmark de vitesse
Testez la vitesse de génération avec un prompt standard :
- Mesurez les tokens par seconde (tokens/s)
- Avec 2x T4, attendez-vous à environ 15-25 tokens/s en Q4
- Le premier token (TTFT – Time To First Token) est crucial pour l’expérience utilisateur

4. Cloudflare Tunnel + OpenCode + Hermes Agent (12:05)
Rendre votre serveur local accessible depuis l’extérieur de manière sécurisée et l’intégrer à des outils de développement.
Cloudflare Tunnel
Cloudflare Tunnel crée un tunnel sécurisé entre votre serveur Kaggle et Internet, sans avoir à ouvrir de ports ou configurer de firewall :
- Installation de cloudflared (le daemon Cloudflare)
- Création d’un tunnel temporaire (valide quelques heures)
- Obtention d’une URL publique de type
https://votre-tunnel.trycloudflare.com - Cette URL expose l’API Ollama (port 11434) de manière sécurisée
# Lancement du tunnel Cloudflare
cloudflared tunnel --url http://localhost:11434

# Vous obtiendrez une URL publique temporaire
Intégration avec Hermes Agent
Hermes Agent est un framework d’agents IA qui peut se connecter à votre serveur Ollama :
- Configuration de l’endpoint API avec votre URL Cloudflare
- Définition des prompts système et du comportement de l’agent
- Création de workflows automatisés
Connexion à OpenCode
OpenCode est un éditeur de code assisté par IA (similaire à GitHub Copilot) :
- Configuration dans les paramètres d’OpenCode
- Ajout de l’URL de votre serveur Ollama
- Sélection du modèle Qwen3.8 27B
- Profitez de l’autocomplétion et de l’assistance au codage en temps réel !
⚡ La Stack Technique Complète
Ce projet repose sur une stack moderne, open-source et entièrement gratuite :
📓 Prêt à commencer ? Téléchargez le notebook Kaggle préconfiguré :
📥 Télécharger le Notebook💡 Astuces pour Optimiser les Performances
Maximiser la vitesse de génération
- Utilisez la quantification Q4_K_M : C’est le meilleur rapport qualité/performance
- Activez MTP : Peut doubler la vitesse de génération
- Gardez le modèle en VRAM : Évitez les rechargements fréquents
- Réduisez le contexte si possible : 64K est utile mais ralentit l’inférence
Gérer les limites Kaggle
- 30 heures GPU/semaine : Suffisant pour du développement et des tests
- Sessions de 12h max : Sauvegardez régulièrement
- 2 GPU simultanés : Vérifiez toujours que les 2 sont actifs
Sécurité et bonnes pratiques
- Cloudflare Tunnel : Ne partagez l’URL qu’avec des personnes de confiance
- Données sensibles : Évitez de traiter des données confidentielles sur Kaggle
- Modèle uncensored : Utilisez de manière responsable
• La disponibilité des GPU dépend de Kaggle et peut varier selon la demande
• Les sessions sont limitées à 12 heures maximum
• L’environnement est temporaire : tous les fichiers sont perdus après la fin de la session
• Les 30 heures de GPU sont renouvelées chaque semaine
• Cette configuration n’est pas adaptée pour un service de production 24/7
• Pour un usage intensif, envisagez un VPS GPU dédié (RunPod, Lambda Labs, etc.)
🎬 Regarder le Tutoriel Vidéo Complet
Suivez la démonstration pas à pas en vidéo. Cliquez sur la miniature pour lancer la vidéo ou utilisez les chapitres pour accéder directement aux sections qui vous intéressent.
Chapitres de la vidéo
❓ Questions Fréquentes
Le modèle est-il vraiment gratuit ?
Oui ! Kaggle offre 30 heures de GPU gratuitement chaque semaine. Le modèle Qwen3.8 27B est open-source et gratuit. Ollama est également gratuit et open-source.
Puis-je utiliser ce setup en production ?
Pour du prototypage et des tests, oui. Pour la production, préférez un VPS GPU dédié (RunPod, Lambda Labs, AWS, etc.) car les sessions Kaggle sont temporaires et limitées à 12h.
Quelle est la différence entre Q4, Q5, Q8 ?
Ce sont des niveaux de quantification. Q4 (4-bit) est le plus léger (~17 Go), Q8 (8-bit) est plus lourd (~29 Go) mais plus précis. Q4_K_M offre le meilleur compromis.
Le modèle uncensored est-il dangereux ?
Un modèle « uncensored » n’a pas de filtres de sécurité intégrés. Il répondra à toutes les questions sans refus. Utilisez-le de manière responsable et éthique.
Puis-je utiliser d’autres modèles ?
Oui ! Ollama supporte des centaines de modèles. Avec 32 Go de VRAM, vous pouvez exécuter des modèles jusqu’à ~30B en Q4 (Llama, Mistral, etc.).